Человек входит в комнату и почти мгновенно понимает, что перед ним стол, дверь, чашка, человек и свободный проход между мебелью. Мы редко замечаем, сколько операций выполняет мозг: глаза передают изображение, мозг оценивает расстояние, узнает предметы, отделяет движущиеся объекты от неподвижных и одновременно помнит, где мы находимся.
Роботу приходится решать похожие задачи другим способом. Вместо глаз у него могут быть камеры, LiDAR, радар, ультразвуковые датчики, IMU, энкодеры в колесах и датчики силы в пальцах. Ни один сенсор не дает полной картины сам по себе. «Зрение» возникает, когда компьютер объединяет сигналы и строит собственную цифровую модель пространства.
Поэтому робот не просто смотрит на мир. Он постоянно его измеряет.
Камера видит картинку, но этого мало
Обычная камера передает поток пикселей с цветом и яркостью. Для человека стул сразу выглядит как стул определенного размера и примерно на определенном расстоянии. Для компьютера сначала это только числа.
AI-модель должна определить, какие пиксели принадлежат предмету, полу, человеку или тени, затем понять движение и свободное пространство. Этим занимается computer vision. NVIDIA Isaac ROS объединяет perception, localization и mapping и показывает, как камеры и AI-модели работают непосредственно на роботе.
Но обычная камера плоская: в изображении нет готовой цифры расстояния. Ее нужно получить дополнительно.
Два «глаза» дают глубину
Две камеры позволяют использовать стереозрение. Они видят сцену с немного разных точек, а компьютер сравнивает положение одинаковых деталей и рассчитывает глубину.
Так появляется depth map — карта, где пиксель может содержать не только цвет, но и приблизительное расстояние до поверхности. Для автономного робота это позволяет понимать, где находится стена, коробка, человек или свободный проход.
LiDAR измеряет пространство лазером
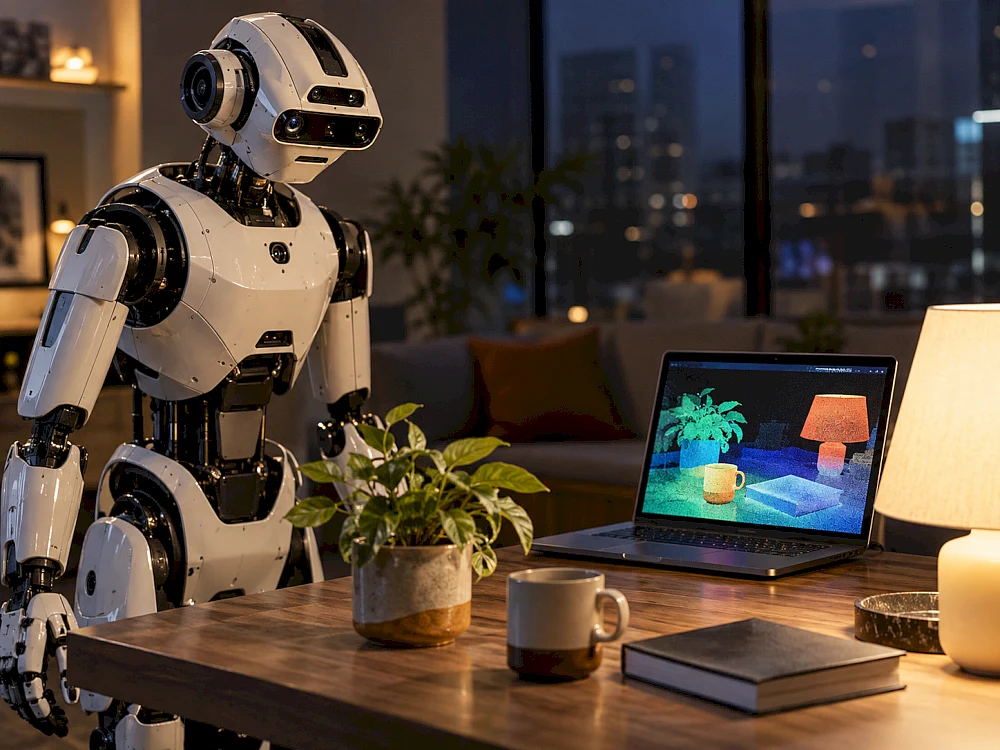
LiDAR посылает световые импульсы и измеряет время их возвращения. Тысячи таких измерений создают облако точек — трехмерную геометрию пространства.
По нему робот может найти стены, пол, автомобили, препятствия и края объектов. Isaac Sim позволяет даже моделировать камеры, LiDAR, радары и другие сенсоры в виртуальной среде до создания физического робота.
Зачем нужен радар
Радар использует радиоволны и особенно хорошо измеряет расстояние и движение. Он полезен как независимый канал, когда камере мешает плохое освещение, туман или другие условия.
У бытового робота набор сенсоров может быть проще. Роботу-пылесосу не обязательно знать, что перед ним конкретная модель стула. Ему достаточно понять: здесь препятствие.
Робот чувствует собственное движение
IMU содержит акселерометры и гироскопы. Они сообщают об ускорении, вращении и наклоне. Робот может понять, что поворачивает, его толкнули или он начинает терять равновесие.
Энкодеры в моторах и суставах показывают положение колес и конечностей. Таким образом, система одновременно оценивает внешний мир и собственное тело.
Осязание тоже часть восприятия
Роботической руке недостаточно камеры. Tactile sensors и датчики силы помогают понять, что предмет уже зажат, начинает выскальзывать или сжат слишком сильно.
Без этого робот может идеально распознать яйцо и все равно раздавить его.
Главное — sensor fusion
Камера ошибается. LiDAR имеет свои ограничения. IMU накапливает погрешность, колеса могут проскальзывать. Поэтому данные объединяются.
Камера видит человека, depth camera оценивает расстояние, LiDAR подтверждает объект, радар — движение, IMU сообщает о повороте самого робота, энкодеры — о положении колес. Из всех сигналов система формирует наиболее вероятную картину.
Как робот понимает, где он сам
Для этого используется SLAM — Simultaneous Localization and Mapping. Робот одновременно строит карту и определяет свое положение на ней.
Двигаясь, он находит характерные точки, оценивает собственное перемещение и постепенно создает карту. Именно поэтому робот-пылесос может показать план квартиры, а более сложный мобильный робот — трехмерную карту дверей, лестниц и проходов.
Spot показывает разницу между человеческим и машинным зрением
Четвероногий Spot от Boston Dynamics использует несколько стереокамер глубины вокруг корпуса. Согласно спецификациям производителя, depth cameras помогают строить карту ближайшего пространства и избегать препятствий.
Но даже такая система имеет слабые места. Тонкие кабели, прозрачное стекло и некоторые поверхности могут быть плохо заметны для геометрической карты. Boston Dynamics исследует visual foundation models именно потому, что одной геометрии недостаточно для полного понимания сцены.
Почему робот иногда не видит очевидное
Темнота, яркий контровой свет, зеркала, стекло, блестящие поверхности, туман, дождь и очень тонкие предметы могут создавать проблемы. Камеры также имеют слепые зоны. Boston Dynamics отдельно описывает ограничения obstacle avoidance.
Поэтому безопасный робот должен уметь работать с неопределенностью: если система не уверена, что путь свободен, она должна замедлиться или остановиться.
Увидеть предмет и понять его — не одно и то же
Computer vision может распознать стол, чашку, человека и дверь. Но универсальному роботу нужно понимать, что чашку можно взять за ручку, дверь может открыться, человек способен внезапно сделать шаг, а мокрый пол требует другой скорости.
Так perception переходит в physical AI: система связывает увиденное с возможным действием.
Видит ли робот мир так же, как человек?
Нет. Для человека комната — это предметы, цвета, знакомые лица и смысл. Для робота она одновременно может быть RGB-изображением, depth map, облаком точек, семантическими классами, координатами собственного положения и картой проходимости.
Человек видит стул. Робот может видеть объект с координатами X, Y, Z, классом «chair» и областью, через которую нельзя прокладывать маршрут.
Как будут видеть роботы будущего
Главный прогресс будет связан не только с лучшими камерами, а с мультимодальными моделями, которые одновременно видят изображение, понимают язык, помнят карту, анализируют прикосновение и планируют действие.
Но физический мир намного менее предсказуем, чем текст на экране. Поэтому путь от AI, который хорошо описывает фотографию, до робота, надежно работающего среди людей, остается сложным.
Так как робот видит окружающий мир?
Не одним способом. Камера дает цвет и форму. Stereo/depth camera — расстояние. LiDAR — геометрию. Радар — движение и дополнительную оценку расстояния. IMU — собственное движение. Энкодеры — положение колес и суставов. Датчики прикосновения — контакт с предметами.
AI интерпретирует эти сигналы, а sensor fusion и SLAM собирают их в общую модель.
Настоящие «глаза» робота — это вся система сенсоров, алгоритмов и AI, которая непрерывно превращает физический мир в цифровую модель, достаточно точную для следующего действия.