Людина заходить у кімнату й майже миттєво розуміє, що перед нею стіл, двері, чашка, людина і вільний прохід між меблями. Ми не замислюємося, скільки операцій у цей момент виконує мозок: очі передають зображення, мозок оцінює відстань, впізнає предмети, відокремлює рухомі об’єкти від нерухомих і водночас пам’ятає, де ми перебуваємо.
Роботові доводиться вирішувати приблизно ті самі задачі, але іншим способом. Він може мати камери замість очей, LiDAR для вимірювання відстані, радар, ультразвукові сенсори, інерційні датчики, енкодери в колесах і датчики сили в пальцях. Окремо жоден із них не дає повної картини. «Бачення» виникає тоді, коли комп’ютер об’єднує сигнали й будує власну цифрову модель простору.
Тому робот не просто дивиться на світ. Він постійно його вимірює.
Камера бачить приблизно те саме, що й ми — але цього недостатньо
Звичайна камера передає потік пікселів із кольором та яскравістю. Для людини цього часто достатньо: ми бачимо стілець і відразу приблизно розуміємо його форму, розмір та відстань.
Для комп’ютера спочатку це лише масив чисел. AI-модель повинна визначити, які пікселі належать стільцю, які — підлозі, людині чи тіні, потім оцінити рух і зрозуміти, чи можна пройти поруч. Цим займається computer vision. NVIDIA Isaac ROS об’єднує perception, localization і mapping та показує, як сучасні робототехнічні системи поєднують камери й AI-моделі безпосередньо на роботі.
Але звичайна камера має фундаментальне обмеження: фотографія плоска. У ній немає готової цифри «цей стілець стоїть за 1,8 метра». Відстань потрібно отримати окремо.
Два «ока» дають роботові глибину
Один із природних способів — дві камери. Приблизно так працює людський стереоскопічний зір: ліве й праве око бачать сцену з трохи різних точок, а мозок використовує різницю для оцінки глибини.
Робот робить це математично. Дві камери знаходять однакові точки в кадрі й вимірюють їх зміщення. Так формується depth map — карта, де кожен піксель може мати не лише колір, а й приблизну відстань до поверхні.
Для автономної машини або робота це вже дуже практична інформація: стіна за 3,4 метра, коробка за 1,2 метра, нога людини за 85 сантиметрів. На основі такої карти можна планувати рух.
LiDAR вимірює простір світлом
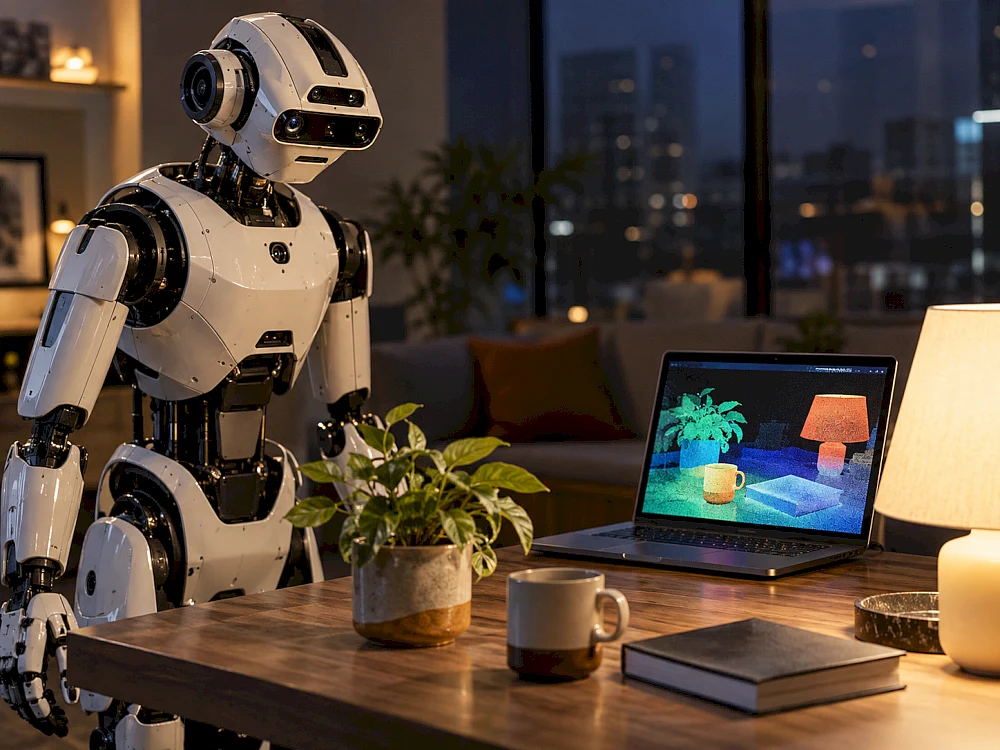
Багато автономних роботів використовують LiDAR — Light Detection and Ranging. Пристрій посилає лазерний імпульс і вимірює час його повернення від поверхні. Повторюючи вимірювання у багатьох напрямках, робот отримує хмару точок.
Для людини вона може виглядати як абстрактний набір координат, але для машини з неї легко визначити стіну, підлогу, автомобіль, край дороги або іншу перешкоду. У робототехніці стереокамери, 2D/3D LiDAR, радари, контактні та інерційні сенсори часто працюють разом. Isaac Sim дозволяє навіть симулювати такі сенсори до створення фізичного робота.
Навіщо роботові радар
Радар використовує радіохвилі й особливо добре визначає відстань та швидкість рухомих об’єктів. Камері потрібне світло, а оптичні сенсори можуть мати проблеми в дощі, тумані або з певними поверхнями. Радар бачить сцену інакше й тому корисний як додатковий незалежний канал.
Побутовому роботу набір сенсорів часто простіший. Роботу-пилососу не потрібно знати марку стільця — достатньо зрозуміти: тут перешкода, сюди їхати не можна.
Робот відчуває навіть те, чого не бачить
Для відчуття власного руху використовується IMU — inertial measurement unit. Акселерометри й гіроскопи повідомляють про прискорення, обертання та нахил. Робот розуміє, що він почав повертатися, його штовхнули або корпус втрачає рівновагу.
Енкодери в моторах і суглобах показують, наскільки повернулося колесо чи зігнулася нога. Тобто робот одночасно оцінює, що відбувається навколо, і що відбувається з його власним тілом.
Дотик теж є частиною сприйняття
Для роботичної руки одного зору недостатньо. Людина, беручи чашку, відчуває тиск пальців, вагу й ковзання. Роботові для цього потрібні tactile sensors — датчики сили й дотику.
Вони можуть визначати, що предмет уже затиснутий, починає вислизати або що хват надто сильний. Без цього роботична рука може чудово побачити яйце камерою і все одно розчавити його.
Найважливіше — sensor fusion
Окрема камера помиляється. LiDAR теж має обмеження. IMU накопичує похибку, колеса можуть проковзнути. Тому робототехніка використовує sensor fusion — об’єднання сенсорів.
Камера говорить: попереду людина. Depth camera оцінює відстань. LiDAR бачить об’єкт. Радар підтверджує рух. IMU повідомляє, що сам робот повертає. Енкодери показують, наскільки повернулися колеса. Із цих сигналів комп’ютер формує одну найбільш імовірну картину.
Як робот розуміє, де він сам
Побачити кімнату недостатньо — потрібно ще знати власне положення в ній. Для цього використовується SLAM, Simultaneous Localization and Mapping: одночасна локалізація та побудова карти.
Складність у замкненому колі: щоб побудувати карту, потрібно знати, де ти знаходишся, а щоб точно визначити положення, потрібна карта. SLAM вирішує обидві задачі разом. Робот рухається, знаходить характерні точки, оцінює переміщення й поступово формує карту.
Саме тому робот-пилосос після кількох поїздок квартирою може показати досить впізнаваний план кімнат, а складніший робот — тривимірну карту дверей, сходів, проходів і тимчасових перешкод.
Spot добре показує, як відрізняється машинний зір
Чотириногий Spot від Boston Dynamics використовує кілька стереокамер глибини навколо корпусу. За даними виробника, система depth cameras допомагає будувати карту найближчого простору та уникати перешкод.
Але навіть складна система не бачить ідеально. Boston Dynamics окремо описує проблеми тонких кабелів, прозорого скла та інших об’єктів, які можуть бути недостатньо помітними для геометричної карти. Visual foundation models використовуються саме тому, що простого вимірювання геометрії не завжди достатньо, щоб зрозуміти сцену.
Чому робот може не побачити очевидну перешкоду
Проблемами можуть бути темрява, сильне контрове світло, дзеркала, прозоре скло, блискучі поверхні, туман, дощ, дуже тонкі предмети або незвична форма об’єкта. Навіть кілька камер можуть мати невеликі сліпі зони. Boston Dynamics прямо описує межі obstacle avoidance у Spot.
Тому безпека автономного робота будується не на припущенні «AI усе побачить», а на роботі з невизначеністю. Система повинна вміти сповільнитися або зупинитися, якщо не впевнена, що шлях безпечний.
Побачити предмет і зрозуміти його — різні речі
Система computer vision може визначити: це стіл, чашка, людина, двері. Але універсальному роботові потрібно значно більше. Він має розуміти, що чашку можна взяти за ручку, двері можуть відчинитися, людина може раптово зробити крок, а мокра підлога змінює безпечну швидкість руху.
Саме тут computer vision переходить у physical AI. AI не просто класифікує картинку, а пов’язує побачене з можливими діями.
Чи бачить робот світ так само, як людина?
Ні. Для людини кімната складається з кольорів, предметів, знайомих облич, досвіду й значень. Для робота той самий простір може одночасно бути кольоровим кадром, depth map, хмарою точок, набором розпізнаних об’єктів, координатами власного положення, картою прохідності та траєкторіями рухомих об’єктів.
Людина бачить стілець. Робот може бачити поверхню з координатами X, Y і Z, semantic class «chair» та область простору, через яку не можна прокладати маршрут.
Як бачитимуть роботи майбутнього
Головний прогрес полягатиме не лише в камерах більшої роздільної здатності. Значно важливішими стануть мультимодальні AI-моделі, які одночасно бачать кадр, розуміють мову, пам’ятають карту, аналізують дотик і планують дію.
Але фізичний світ значно менш передбачуваний, ніж текст на екрані: слизька підлога, прозорі двері, предмет, що впав, або людина, яка несподівано змінила напрямок. Саме тому шлях від AI, який добре описує фотографію, до робота, що надійно працює серед людей, набагато складніший.
То як робот бачить навколишній світ?
Не одним способом. Камера дає колір і форму. Стереокамера або depth camera — відстань. LiDAR — геометрію простору. Радар — додаткові дані про рух і відстань. IMU — відчуття власного переміщення. Енкодери — положення коліс і суглобів. Датчики дотику — контакт із предметами.
AI намагається зрозуміти, що означають ці сигнали, а sensor fusion і SLAM збирають їх у спільну модель світу.
Тому справжні «очі» робота — це не одна камера, а вся система сенсорів, алгоритмів і AI, яка безперервно перетворює фізичний світ на цифрову модель, достатньо точну для наступної дії.